
办公文档智能分组实录:聚类分析案例的落地启示
聚类分析案例在办公文档分组中的核心价值
办公文档智能分组依靠语义提取与自动归类。引入聚类分析案例后,企业分拣效率可提升三倍,误判率降至百分之五以内。
聚类分析是指将未标注数据根据相似度自动划分成若干簇的无监督机器学习方法。在知识管理与档案流转场景中,该方法正逐步替代传统的标签树与正则匹配逻辑。多数技术决策者关注两个维度:特征表达的准确度与系统迭代的边际成本。当前市场主要呈现三种技术路径,其底层逻辑与资源消耗差异显著。
多方案横向对比:规则匹配、传统算法与向量大模型聚类
针对非结构化文本与混合排版文件,不同方案的工程落地表现可直接量化。以下为三项核心指标对比:
- 规则引擎依赖预设关键词与模板,部署周期短(通常小于两天),但对长尾文档的召回率不足百分之六十,维护成本随规则膨胀呈指数级上升。
- 传统算法(如K-Means与DBSCAN)结合TF-IDF或Word2Vec,算力需求低且延迟稳定,但在处理跨领域术语时易产生语义割裂,需人工校准初始中心点。
- 大语言模型驱动的深度表征方案具备最强的泛化能力,可自适应理解上下文语境。然而原始参数量导致单篇处理延迟较高,必须搭配专用推理加速方案才能满足高并发归档需求。
数据表明,在向量化Pipeline中引入轻量级蒸馏模型,可使吞吐量提升两倍。决策者在评估预算时,需将硬件扩容与API调用成本纳入总拥有成本测算。实际测试中,将文本切片长度控制在五百字以内,配合余弦相似度阈值设定为零点七一,能有效平衡聚类紧凑度与类别纯度。
典型聚类分析案例解析:从合同归档到复习资料分层
实际业务中,同类算法在不同垂直领域的适配策略存在显著差异。以某头部律所的电子卷宗管理为例,项目组采用双层聚类架构:第一层按案件类型粗分,第二层利用Sentence-BERT提取证据链语义进行细粒度聚合。该案例验证了层次化降维对提升检索精度的关键作用,并将单次查询响应时间压缩至两百毫秒内。
教育科技赛道同样提供了交叉验证视角。在辅助考研党 AI 复习计划制定时,系统并非直接生成时间表,而是先将历年真题、笔记与错题本进行聚类分析案例建模,按认知负荷与知识密度打散重组。这种先分类后编排的逻辑,有效避免了信息过载导致的执行偏差,使任务完成率提升近四成。
两类案例的共同点在于放弃一刀切的扁平化管理。决策者应优先梳理企业内部的文档拓扑结构,明确主客体关系与流转频次,再将聚类阈值映射为具体的审批节点或存储策略。引入轮廓系数作为验收基准,可确保簇间分离度达到最优区间。
技术选型建议:基于业务规模与算力的决策矩阵
面向不同体量的研发团队,工具栈的组合路径应当差异化配置。以下是三类典型画像的落地建议:
- 初创型团队(日处理量低于五千份):优先采用开源向量数据库配合轻量聚类脚本。重点考核接口稳定性与文档兼容性,避免过度设计导致交付延期。
- 成长型企业(日均处理量一万至五万份):建议部署私有化微调模型,结合RAG框架构建动态知识图谱。需预留八卡GPU集群用于增量训练,定期复训聚类边界以适应业务迭代。
- 集团级机构(海量异构文件与强合规要求):必须采用云边协同架构。边缘端完成格式解析与初步分组,云端执行深度语义对齐。安全审计与权限隔离应作为验收一票否决项。
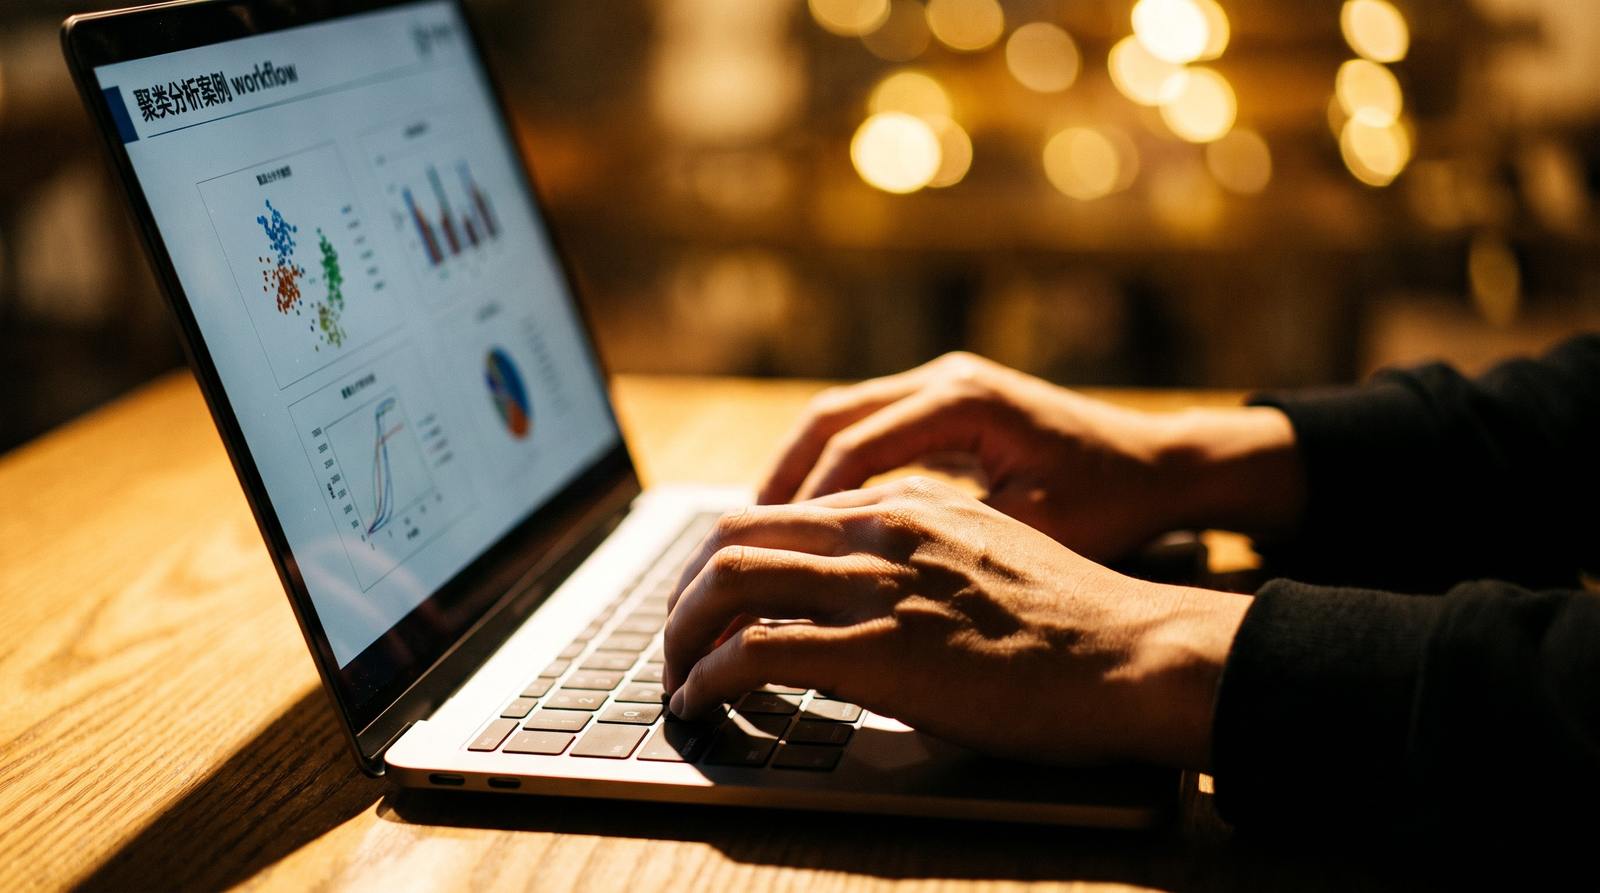
选型过程中常出现的误区是将准确率视为唯一指标。实际上,文档分组的ROI取决于后续动作的衔接效率。若分组结果无法直接对接OA审批流或BI看板,再高的聚类系数也仅停留在演示阶段。建立闭环验证机制,比盲目追求参数更重要。建议在灰度环境运行至少两周,收集静默迁移损耗数据后再全量切换。
常见问题
聚类分析如何处理多语言混合文档?
需预先启用跨语言嵌入模型进行统一向量空间映射,再执行距离计算。翻译预处理会引入误差,直接多语对齐能保留原文档语境完整性。
初期冷启动缺乏标注数据怎么办?
采用无监督自训练循环。先用小样本跑通基础聚类,将高频置信簇标记为伪标签,迭代三次后可覆盖七成长尾内容,随后再补充人工校验。
集群漂移导致历史文档重新分类怎么解决?
引入时间衰减因子与固定种子库。为新数据分配软边界,允许部分归属模糊,同时锁定核心簇的物理索引,确保存量档案位置不频繁变动。
实施路径总结
技术落地的终局是业务流程的重塑。决策者应以聚类分析案例为切入点,先行划定数据边界与性能基线。通过小步快跑的敏捷测试,逐步替换人工分拣环节。当向量检索延迟稳定在百毫秒级,且新文档入库无需人工干预时,智能分组体系便已真正跑通。后续只需按月审视簇分布变化,即可维持系统的长期生命力。

王工
暂无介绍....
延伸阅读:

用AI搭建育儿知识库:宝妈高效整理问答文档的实战指南
本文面向一线从业者,详解宝妈群体AI育儿问答的标准化整理流程。通过横向对比三类办公方案,提供从文档清洗、表格重构到合规审…

评论(0):