
构建垂直AI助手的核心步骤:数据喂养与指令优化
步骤一:界定业务边界与执行垂类数据喂养
构建垂直AI助手的核心步骤是精准收集领域专有语料并进行结构化清洗,随后通过分层指令模板与反馈闭环持续调优模型输出,最终实现高可用落地。
对于初入职场的技术管理者而言,落实《职场新人构建垂直领域专属AI助器的垂类数据喂养与指令优化指南》不仅是工具选型的基础,更是控制项目风险的必经环节。垂直AI助器并非通用大模型的简单套壳,而是针对特定业务流定制的推理单元。其底层逻辑依赖于高质量语料的定向注入与提示词工程的精细化编排。在数据喂养阶段,需严格遵循“质量优于数量”与“脱敏优先”的硬性指标。具体操作应分为以下三个递进动作:
- 定向采集:深度挖掘内部Wiki、历史工单、标准作业程序(SOP)及行业合规手册,建立专属语料池,剔除过期、冗余及相互矛盾的文本片段。
- 结构化清洗:利用Python正则表达式与规则引擎进行脏数据过滤、标点规范化与实体消歧,将非结构化文档统一转为Markdown或JSON格式,降低模型解析噪声。
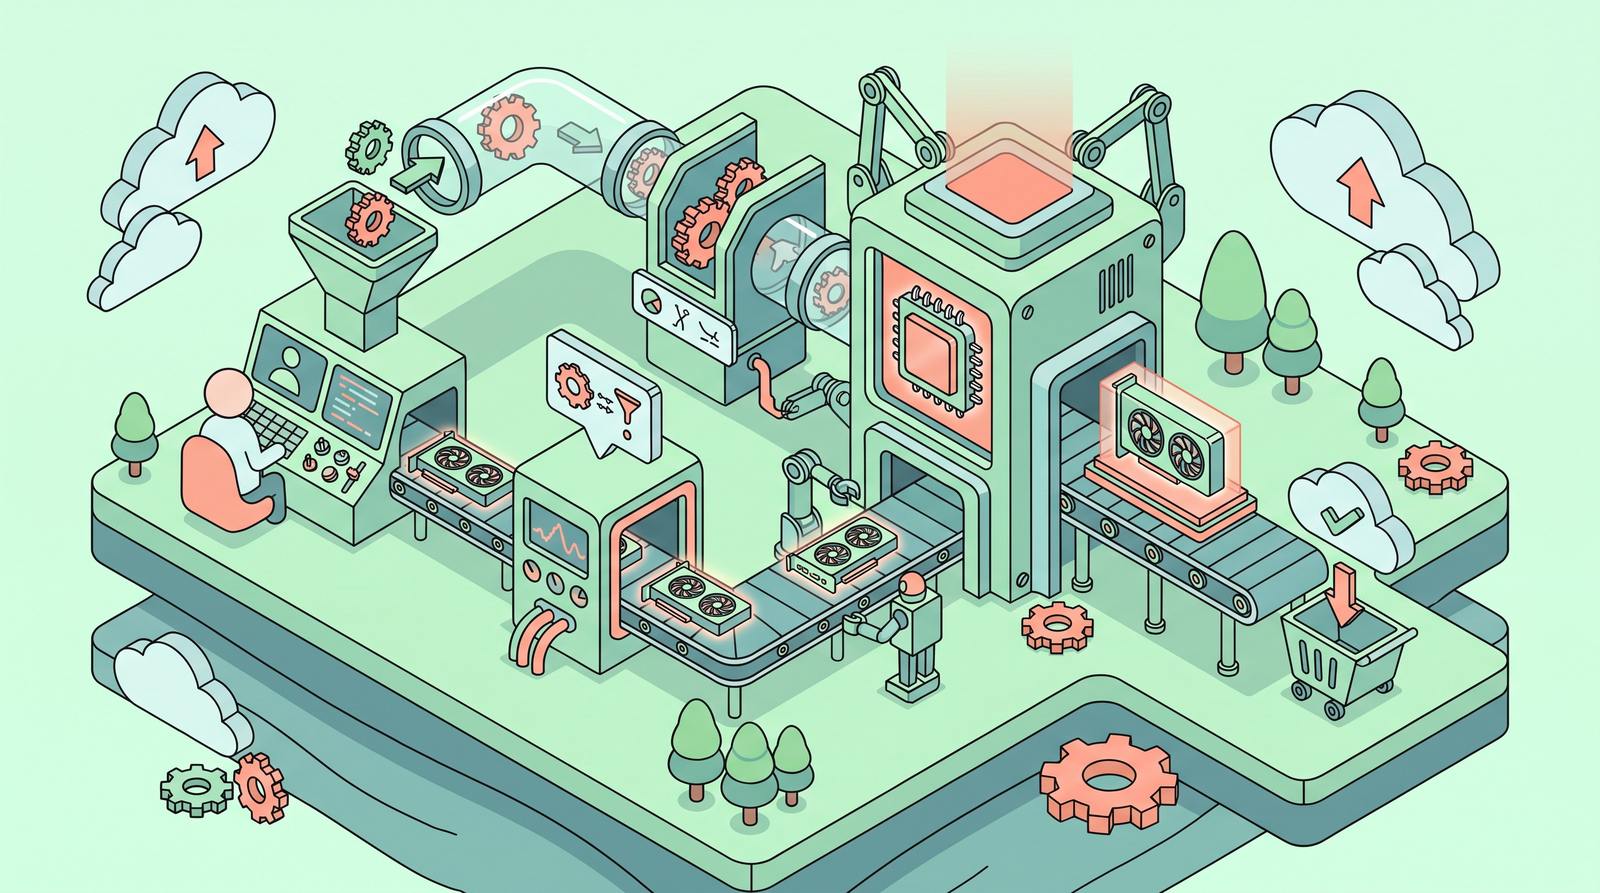
- 知识切片与向量化入库:基于滑动窗口按语义段落切割长文档,计算Embedding向量并存入Milvus或Chroma等轻量级向量数据库,配合检索增强生成(RAG)架构从根本上压制模型幻觉。
决策者在规划数据管道时,务必明确数据的生命周期与更新频率。静态参考资料可采用定期批量导入,而动态业务流则需配置定时任务或Webhook接口实现实时同步。只有打通从源头捕获到向量索引的稳定链路,后续的智能问答才具备坚实的事实根基。建议设立数据回流通道,将用户实际提问与最终采纳的回复存入经验库,定期用于训练轻量级分类器,实现语料生长的正向循环。
步骤二:搭建分层指令架构与提示词优化
指令优化是决定助手专业度与交互稳定性的核心变量。提示工程是指通过结构化文本引导语言模型生成符合预期结果的交互技术。在技术选型决策中,建议彻底告别碎片化的单轮问答请求,转而采用“角色设定+上下文约束+输出规范”的三段式系统框架。该架构能有效隔离外部干扰,确保模型在复杂职场场景中的逻辑连贯性。实施路径如下:
- 锚定专家Persona与边界:明确赋予助手特定岗位身份(如“资深财务审计员”),同步注入行业术语表、合规红线与禁用词库,划定能力天花板。
- 植入思维链CoT推导:强制要求模型在输出最终结论前,先列出分析依据、排除条件与分步计算过程,利用显式推理链条大幅提升复杂逻辑题的准确率。
- 配置少样本Few-Shot对齐:精选3至5组涵盖典型场景的正负向样本,直观展示输入意图与理想回复的映射关系,快速收敛模型输出分布。
优化过程中必须引入灰度测试与基准对照机制。初次部署时,应将模型温度参数(Temperature)锁定在0.1至0.3的保守区间,优先保障输出的确定性与业务可复用性。待指令库经过多轮A/B测试验证稳定后,再针对创意撰写等发散型任务逐步放宽随机性。所有提示词的变更都必须纳入Git版本管理,保留完整的修改轨迹与效果日志,以便在业务指标异常时一键回滚。同时,需关注提示词注入攻击的防御,通过在System Prompt末尾追加安全围栏语句,可有效阻断恶意诱导。
步骤三:跑通验证闭环与技术选型决策
任何指令模板与数据管线都需经过严苛的沙盒推演,方可正式接入企业生产环境。决策者在此阶段常陷入算力预算与开发平台的抉择,此时系统性地参考一份在线编程环境资源对比报告能大幅缩短基础设施的适配周期。不同云厂商提供的代码解释器与容器沙箱在并发吞吐、网络白名单策略及API调用计费模型上差异显著,选型需紧密贴合团队现有的DevOps规范。选定底层支撑后,必须将高频真实用例输入系统进行端到端压测。
验证体系的核心在于建立自动化的纠错与分级复核机制。以跨部门协作中最典型的会议协作为例,一套成熟的垂类助手应当无缝衔接AI会议纪要自动生成后的信息核实流程。系统需自动抽取关键Action Item、指派责任人与里程碑节点,并与原始音频逐句交叉比对,对置信度低于预设阈值的陈述进行高亮标记,交由人类专家复核确认。此双重校验机制是保障输出准确性、规避合规风险的最后一道防火墙。复核环节不应仅停留在文字层面,还需建立业务规则校验脚本,用代码逻辑弥补大模型的概率性缺陷。当召回率与精确率持续稳定在考核基线之上时,即可通过OAuth协议对接企业协同平台,完成产品化发布。
常见问题
垂类数据喂养是否必须采购昂贵的外部标注平台?
初期完全不必。可利用开源脚本配合大模型辅助完成半自动化清洗,重点保持字段一致。待日均处理量突破万级且人工瓶颈显现时,再引入专业标注工具提升人效比。
提示词频繁微调迭代会不会导致原有模型能力退化?
科学迭代不会引发退化。关键在于严格执行变量控制原则。每次仅修改单一模块(如仅调输出格式或更换示例),并配套自动化测试集监控各项指标波动,防止多参数混乱叠加。
技术选型时如何客观量化垂直助器的长期投资回报?
直接对标任务替代率与人工纠错工时。若助手能将常规文档流转耗时压缩40%以上,且月度校验成本持续低于订阅费,建议引入NPS净推荐值辅助评估组织接受度与投资回收周期。

陈工
暂无介绍....


评论(0):