
文档智能解析入门:通俗解读核心原理与选型逻辑
文档智能解析入门:核心概念与技术边界
文档智能解析指将非结构化文件转为机器可读数据的技术。选型应基于业务精度要求、预算与开发资源,建议先用云API跑通流程,再评估自研或私有化部署。文档智能解析的核心价值在于打通数据采集断点,使企业能够将扫描件、票据或合同转化为结构化字段,直接对接下游工作流引擎。
对于零基础起步的技术负责人而言,理解该技术的能力边界比盲目追逐参数量更为关键。当前市场产品已从单一光学字符识别演进为视觉感知与语义推理融合的架构。掌握以下原理与评估维度,可快速建立科学的选型认知框架。
- 输入端:支持静态图像、原生PDF、扫描归档文件与混合排版文档
- 处理端:版面网格重建、表格线框提取、跨页逻辑拼接与噪声过滤
- 输出端:标准化JSON对象、带坐标锚点的Markdown文本或数据库直写通道
文档智能解析的底层架构与执行流程
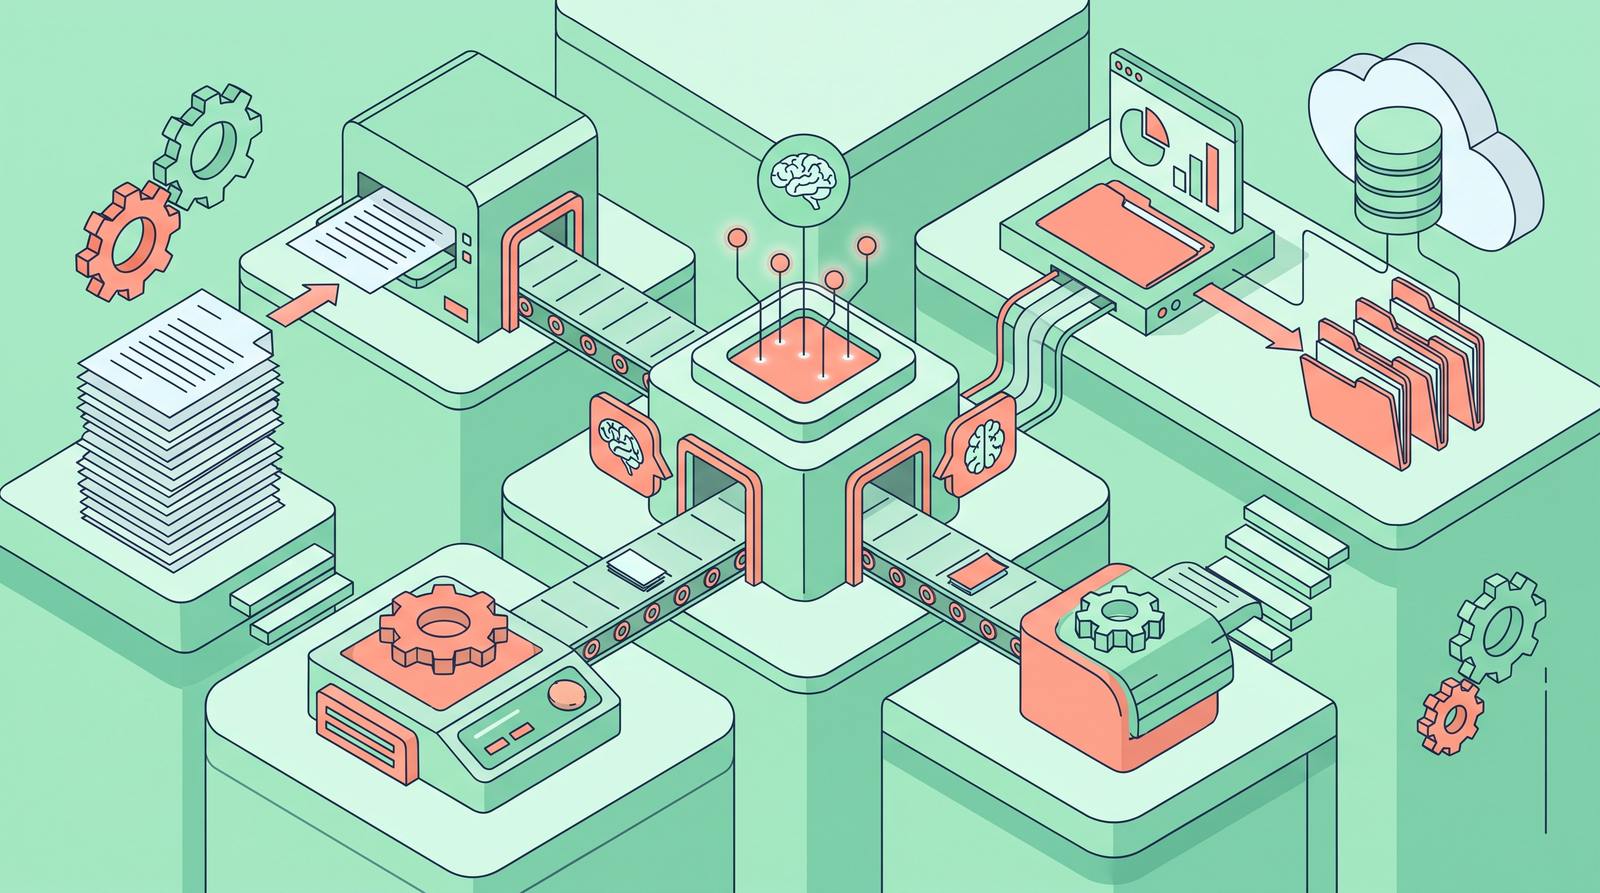
传统正则表达式已无法应对复杂版式干扰。现代解析管线依赖模块化协同,标准执行步骤如下:
- 图像预处理与自适应二值化:执行透视变换校正倾斜角,应用CLAHE算法增强对比度,统一像素分布以降低后续特征提取误差
- 版面分析与目标检测:利用CNN-ViT混合骨干网划分标题、段落、表格与附件区域,构建空间拓扑邻接矩阵
- 字符序列识别:通过CRNN或DETR架构输出字符合集,解决连笔、印章遮挡与低分辨率渲染导致的误识
- 大模型语义增强:注入指令微调后的LLM进行上下文消歧、字段映射与实体对齐,消除孤立识别产生的逻辑断裂
该架构的设计逻辑在于职责解耦。视觉模块负责几何还原,语言模型负责逻辑重组。在工业场景中,两者算力分配需严格匹配需求。例如财务单据解析侧重高保真行列对齐,而法务合同审查更依赖长距离依赖捕捉。技术团队应在部署前确定各阶段置信度阈值,避免无效算力消耗。
主流技术路线横向对比:API服务、开源框架与私有化方案
面对不同的算力储备与合规要求,企业通常在三类方案中权衡。以下从准确率、响应延迟、TCO与运维复杂度四个维度进行客观对比:
- 商业云服务API:端到端F1指标稳定在93%-97%,平均首字延迟低于1.5秒,按Token或页数阶梯计费。适合业务波峰波谷明显、缺乏算法工程团队的部门,但需承担数据流转的合规审计成本
- 轻量级开源组件(如PaddleOCR、DocLayNet变体):本地容器化部署无外网依赖,单次推理边际成本趋近于零。初始环境联调耗时约4-6天,需自行负责版本升级、算子适配与故障恢复
- 企业级私有化全栈方案:提供GPU调度集群、领域语料标注平台与全链路审计网关。前期基础设施投入较高,适用于金融清算、医疗病历等强监管场景,支持自定义词表注入与权限隔离
实际决策常陷入唯精度指标误区。精度跃升往往伴随推理耗时增加与内存占用指数级增长。建议以POC灰度阶段的真实样本分布为准,设定动态降级策略。例如内部报销审批可接受局部字段留空待人工补录,但资金对账链路必须配置硬性拦截与人工复核兜底机制。
企业级文档智能解析选型决策与落地路径
技术负责人的核心任务是平衡技术指标、交付周期与投资回报率。以下是可复用的决策流水线:
- 盘点输入源画像:抽取历史样本统计版式分布,确认是否包含手写批注、反光介质或非常规字体,据此决定是否采集专项训练集
- 核定性能基线:根据业务并发峰值推算TPS要求,若瞬时请求突破800 QPS,必须前置消息队列削峰与实例自动扩缩容策略
- 构建容错与回流闭环:预留专家审核控制台,设计Badcase一键打标接口,确保模型迭代具备持续流入的高质量负样本
- 落实安全合规审查:核对数据驻留属地要求,敏感字段实施动态脱敏,满足等级保护三级或ISO27001数据治理规范
落地初期严禁重资产压测。优先采购标准化API完成MVP验证,追踪字段命中率与人工干预频次。当月均调用规模稳定且外部单价超过自建硬件摊销成本时,再启动架构迁移。此渐进路径可有效控制沉没成本,同时保留技术栈的弹性扩展空间。
常见问题
文档智能解析能完全替代人工录入岗位吗?
当前技术仅覆盖高频标准化场景。复杂嵌套版式或严重损毁档案仍需人工介入,系统定位是流程提效而非岗位替换。
如何管控解析链路的隐私数据泄露隐患?
优先采用本地化推理节点,对外传输启用TLS1.3加密。商用接口需签署数据处理附录,关闭原始文件缓存与第三方共享选项。
老旧设备生成的纯图片PDF能否直接接入?
必须经过全文检索层剥离与图像增强预处理。若缺失隐藏文本流,需完整走OCR管线并绑定空间坐标,否则下游系统无法定位元素。
技术演进趋势与持续优化指南
文档智能解析正向多模态认知架构迁移。下一代系统将强化视觉编码器与生成式模型的联合预训练能力,显著降低Prompt调试门槛。建议团队按月同步公开基准测试榜单,结合内部业务沉淀高精度标注集。密切关注模型量化蒸馏进展,可在维持解析精度的前提下压缩推理占位,实现边缘侧低成本部署。

李工
暂无介绍....


评论(0):